Le deep learning intrigue autant qu’il fascine. Entre réseaux de neurones, couches cachées et GPU surpuissants, l’IA semble parfois réservée à un cercle restreint d’initiés. Pourtant, derrière ce vocabulaire technique se cache une logique claire, structurée et accessible, même sans bagage scientifique avancé.
À travers des exemples concrets, issus de la santé, de la finance, du e‑commerce ou encore de la cybersécurité, les réseaux de neurones transforment déjà la manière dont les entreprises analysent leurs données et prennent des décisions. Comprendre comment ces algorithmes apprennent, se trompent, se corrigent et montent en échelle ouvre une porte directe vers les usages les plus utiles… et vers quelques limites qu’il vaut mieux connaître.
| Élément clé | Résumé essentiel |
| Principe des réseaux de neurones 🧠 | Systèmes inspirés du cerveau humain capables d’apprendre automatiquement à partir de données. |
| Structure | Organisation en couches reliées entre elles, où chaque neurone transforme l’information reçue. |
| Apprentissage | Ajustement progressif des connexions pour réduire les erreurs de prédiction. |
| Applications | Reconnaissance d’images, traitement du langage, recommandations, automatisation. |
Le deep learning depasse les approches classiques des lors que l entrainement se prolonge.
Deep learning et réseaux de neurones : définitions claires et enjeux concrets
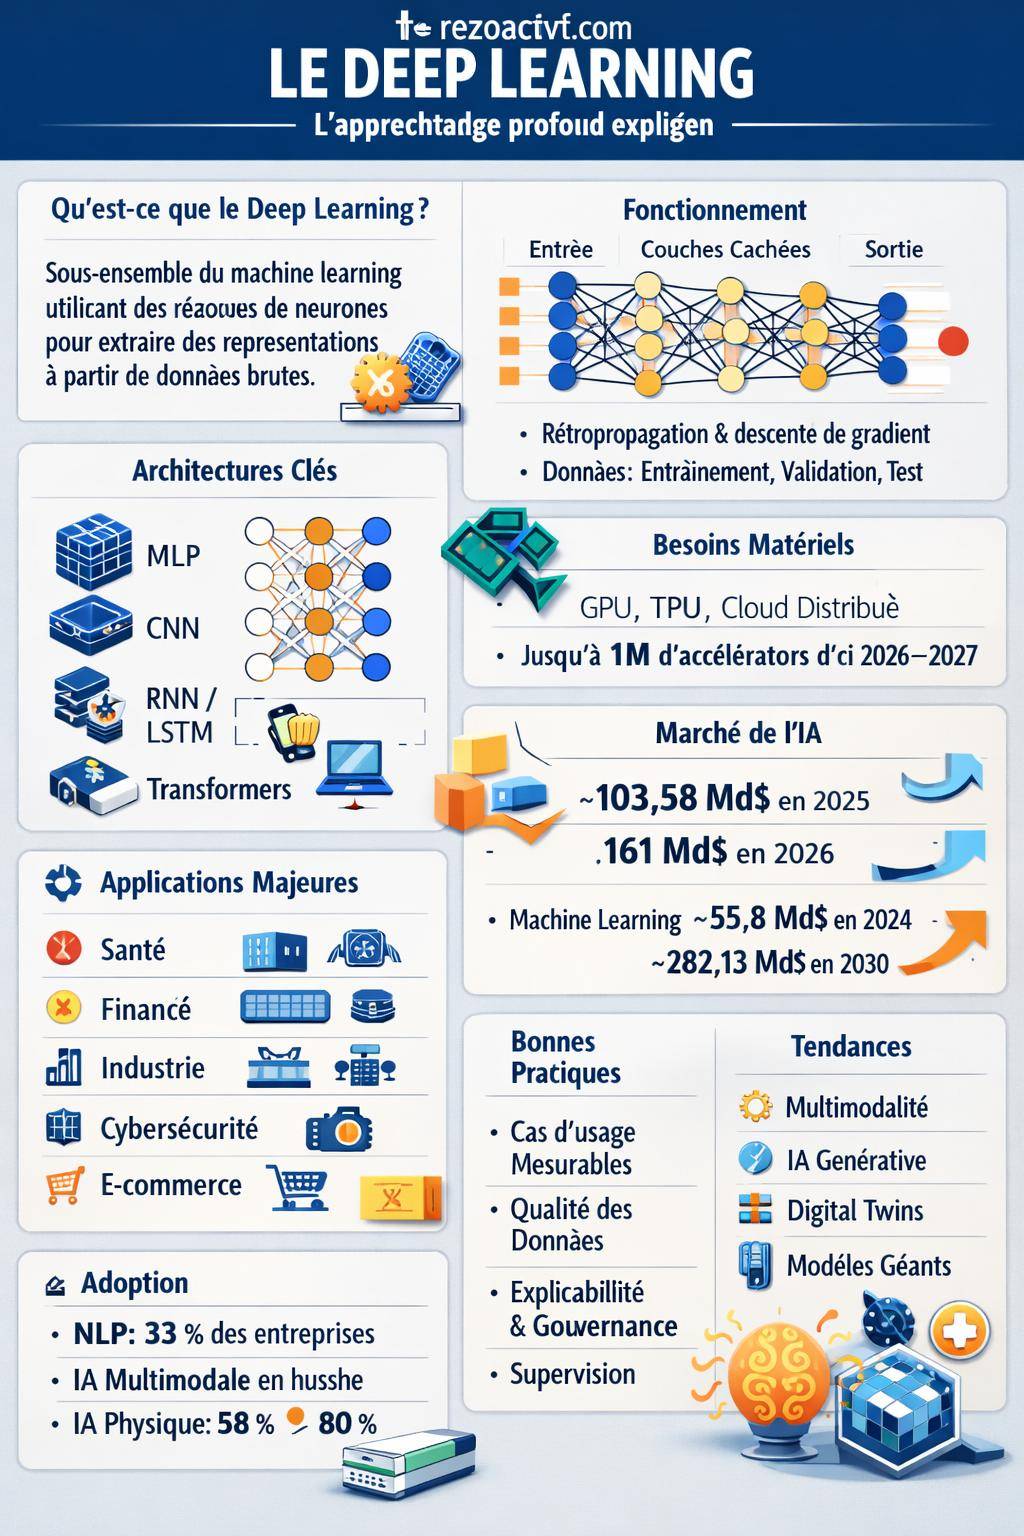
Le deep learning désigne une famille de méthodes d’apprentissage automatique basées sur des réseaux de neurones artificiels profonds. Concrètement, un modèle reçoit des données en entrée, les fait passer à travers plusieurs couches de calcul et produit une sortie : une prédiction, une classification, une décision.
Un réseau de neurones fonctionne comme une chaîne de transformations successives. Chaque couche prend les valeurs provenant de la couche précédente, applique des poids, un biais, puis une fonction d’activation non linéaire. En enchaînant ces opérations, le modèle apprend à extraire des représentations de plus en plus abstraites des données : bords et formes simples, puis motifs, puis concepts complets.
Le deep learning occupe une place centrale dans l’écosystème du machine learning et de l’IA. Il alimente les avancées les plus visibles : modèles de langage de type ChatGPT, systèmes de recommandation, analyse d’images médicales, véhicules autonomes, détection de fraudes ou d’anomalies réseau.
Deep learning, machine learning et IA : bien distinguer les niveaux
L’intelligence artificielle regroupe toutes les techniques qui permettent à une machine de réaliser des tâches qui rappellent un comportement intelligent : planification, raisonnement, perception, langage. Dans ce vaste ensemble, le machine learning se concentre sur l’apprentissage automatique à partir de données.
Le deep learning constitue un sous‑ensemble du machine learning, qui repose sur des réseaux de neurones à plusieurs couches. Là où des algorithmes classiques (régression, forêts aléatoires, SVM) exigent encore un travail manuel de « feature engineering », les réseaux profonds apprennent directement des représentations hiérarchiques dans les données brutes.
Pour aller plus loin sur le paysage complet des approches, un détour par les types et catégories d’IA clarifie la place exacte des réseaux de neurones parmi les autres techniques.
Structure d’un réseau de neurones : du neurone artificiel à l’architecture profonde
Un réseau de neurones moderne repose sur quelques briques très simples, combinées de manière méthodique. Cette structure reste la même, que l’on traite du texte, des images, des signaux médicaux ou des séries temporelles financières.
Le neurone artificiel : une brique mathématique simple
Un neurone artificiel reçoit plusieurs entrées numériques, les multiplie par des poids, ajoute un biais puis applique une fonction d’activation. Le résultat est une valeur unique transmise à la couche suivante.
Cette unité de calcul imite très grossièrement le comportement d’un neurone biologique : plusieurs signaux arrivent, se cumulent, puis déclenchent ou non un « signal de sortie ». La force de chaque connexion (le poids) détermine l’influence de chaque entrée sur la sortie.
En ajustant les poids et les biais sur un grand volume de données, le modèle capture les régularités statistiques utiles à la tâche : distinction entre tumeurs bénignes et malignes, reconnaissance de la voix, détection de transactions frauduleuses ou de perturbations dans un réseau électrique.
Couches, profondeur et architecture globale
Un réseau de neurones rassemble plusieurs neurones organisés en couches :
- une couche d’entrée qui reçoit les données brutes ou prétraitées ;
- une ou plusieurs couches cachées qui transforment progressivement les représentations ;
- une couche de sortie qui produit la prédiction : classe, valeur numérique, probabilité, action.
La profondeur du réseau correspond au nombre de couches cachées. Plus on empile de couches, plus le modèle apprend des motifs complexes, au prix d’un besoin croissant en données, en puissance de calcul et en régularisation.
On distingue plusieurs grandes familles d’architectures :
- réseaux fully connected (MLP) : chaque neurone d’une couche est connecté à tous ceux de la couche suivante ;
- réseaux convolutifs (CNN) : spécialisés dans les images, l’imagerie médicale, la vision industrielle ;
- réseaux récurrents (RNN, LSTM, GRU) : adaptés aux séquences, au texte, au son, aux séries temporelles ;
- Transformers : très utilisés pour le langage naturel et les modèles multimodaux modernes.
Fonctions d’activation : la non‑linéarité au cœur de l’apprentissage
Sans non‑linéarité, même un réseau profond se réduit à une simple transformation linéaire. Les fonctions d’activation introduisent un comportement non linéaire et donnent au modèle la capacité de modéliser des phénomènes complexes.
Les plus courantes incluent la fonction ReLU, la sigmoïde, la tanh ou encore leurs variantes (Leaky ReLU, GELU). Chaque choix influence la vitesse de convergence, la stabilité de l’apprentissage et la capacité de généralisation.
« La profondeur du réseau n’a de sens que si chaque couche ajoute une transformation non linéaire pertinente. Sans cela, le modèle se contente de combiner des lignes droites. »
Comment un réseau de neurones apprend : entraînement, gradient et rétropropagation
L’apprentissage d’un réseau de neurones repose sur un principe simple : comparer la prédiction du modèle à la vérité, mesurer l’erreur, puis ajuster les poids pour réduire cette erreur. L’opération se répète sur de nombreux exemples jusqu’à atteindre un compromis satisfaisant entre précision et robustesse.
Données d’entraînement, jeu de validation et test
Un projet sérieux de deep learning commence par la constitution de jeux de données structurés :
- un jeu d’entraînement pour ajuster les poids du réseau ;
- un jeu de validation pour régler les hyperparamètres (taille du réseau, taux d’apprentissage, régularisation) ;
- un jeu de test totalement séparé pour estimer la capacité de généralisation.
Le volume de données influence directement la qualité du modèle. Dans la santé, par exemple, des milliers d’images d’IRM, de radiographies ou d’ultrasons sont annotées par des spécialistes pour entraîner des modèles de détection de tumeurs cérébrales ou de mélanomes.
Fonction de coût et descente de gradient
La fonction de coût mesure l’écart entre les prédictions du réseau et les étiquettes attendues. En classification, on utilise souvent l’entropie croisée. En régression, l’erreur quadratique moyenne reste une métrique fréquente.
L’algorithme de base pour optimiser les poids s’appelle la descente de gradient. Il consiste à calculer le gradient de la fonction de coût par rapport à chaque poids, puis à déplacer ces poids dans la direction opposée au gradient, avec une certaine intensité définie par le taux d’apprentissage.
Cette descente de gradient s’effectue rarement sur l’ensemble du jeu d’entraînement à la fois. On préfère des méthodes comme le stochastic gradient descent (SGD) ou ses variantes (Adam, RMSProp) qui opèrent sur des mini‑lots (batches) de données pour un compromis entre précision et rapidité.
Rétropropagation de l’erreur : l’algorithme clé
La rétropropagation (backpropagation) calcule efficacement les gradients en remontant l’information d’erreur de la sortie vers les couches d’entrée, couche par couche. Cette procédure exploite la règle de dérivation en chaîne et partage les calculs intermédiaires entre couches.
Grâce à la rétropropagation, le réseau ajuste simultanément des millions, voire des milliards de paramètres. Les grands modèles de langage déployés en production s’appuient sur cette même mécanique, simplement à une échelle très élevée, comme on l’explique plus en détail dans l’article consacré au fonctionnement de ChatGPT.
Types de réseaux de neurones : de la vision à la compréhension du langage
Le deep learning couvre un large éventail d’architectures, chacune adaptée à un format de données spécifique. Cette diversité explique son adoption dans des domaines aussi variés que l’imagerie médicale, la cybersécurité, l’optimisation de réseaux électriques ou le commerce en ligne.
Réseaux convolutifs (CNN) : vision par ordinateur et imagerie médicale
Les CNN exploitent des couches de convolution qui analysent localement les données. Pour les images, ces filtres détectent des motifs visuels : bords, textures, formes, structures anatomiques. Les couches plus profondes combinent ces signaux pour identifier des objets ou des anomalies.
En santé, ces modèles jouent un rôle central :
- détection de tumeurs cérébrales avec des architectures de type Mask R‑CNN, ce qui réduit sensiblement les erreurs humaines en imagerie IRM ;
- analyse de mélanomes sur des images dermatologiques avec une précision proche du niveau d’un médecin spécialiste ;
- diagnostic assisté pour les cancers du sein et de la peau, avec des travaux en cours sur les os et les poumons ;
- accélération de la détection de la malaria, jusqu’à quinze fois plus rapide que les procédures manuelles.
Les CNN sont également omniprésents dans la reconnaissance faciale, la détection d’objets, la surveillance industrielle, le contrôle de qualité en usine et la conduite autonome, où ils interprètent en temps réel les flux de caméras.
Réseaux récurrents (RNN, LSTM, GRU) : séquences, temps et séries
Les RNN et leurs variantes (LSTM, GRU) traitent des données séquentielles. Chaque étape de la séquence dépend des entrées précédentes, ce qui convient bien au texte, à la parole, aux signaux médicaux continus, aux journaux de logs ou aux séries financières.
En finance, ces réseaux modélisent l’évolution de prix, prévoient des comportements de marché ou améliorent des modèles classiques comme ARIMA. Combinés à des architectures de deep learning, ils alimentent des systèmes de trading automatique et des modules d’analyse de tendance.
En santé, ils suivent des signes vitaux au bloc opératoire, évaluent en temps réel la perte de sang, anticipent un risque d’insuffisance cardiaque à partir de l’historique de dossiers cliniques et de signaux physiologiques.
Transformers et modèles de langage : NLP et multimodalité
Les Transformers ont profondément modifié le traitement du langage naturel (NLP). Ils s’appuient sur un mécanisme d’attention qui pondère chaque élément d’une séquence en fonction des autres, sans contrainte de proximité immédiate.
Cette approche a permis de faire émerger des modèles de langage de grande taille capables de :
- générer et résumer des textes ;
- répondre à des questions en langage naturel ;
- réaliser de la reconnaissance vocale précise ;
- analyser des documents longs et hétérogènes.
Le NLP reste déjà adopté par environ un tiers des entreprises, tandis que l’IA multimodale – qui combine texte, image, son, signaux – progresse fortement. Des architectures multimodales fusionnent imagerie médicale, signaux physiologiques et dossiers cliniques pour une médecine de précision dont le marché cible approche plusieurs dizaines de milliards de dollars à horizon 2034.
Entraînement à grande échelle : matériel, infrastructures et coûts
Les réseaux de neurones modernes utilisent des ensembles de paramètres volumineux. Leur entraînement repose sur des accélérateurs matériels spécialisés et des infrastructures distribuées, capables de manipuler des quantités massives de données.
GPU, Trainium, TPU : les moteurs du deep learning
Historiquement, les GPU ont porté l’explosion du deep learning, grâce à leur capacité à effectuer en parallèle un grand nombre d’opérations matricielles. À côté des GPU, d’autres processeurs spécialisés structurent désormais le paysage :
- Trainium2, avec plusieurs centaines de milliers d’unités déjà en service et un objectif d’environ un million d’unités à horizon 2025 ;
- TPU Trillium, avec une montée en charge progressive vers des centaines de milliers d’unités en 2026 puis un objectif proche du million en 2027.
Ces puces optimisent les opérations spécifiques du deep learning : multiplications de matrices, convolutions, normalisations, opérations d’attention. Elles réduisent les temps d’entraînement et les coûts énergétiques par modèle.
Cloud, distribution et scalabilité
L’entraînement de modèles de grande taille s’effectue de plus en plus sur des infrastructures cloud, qui allouent à la demande des grappes de GPU ou d’accélérateurs dédiés. Les données se répartissent entre machines, tout comme les paramètres du modèle.
Les développeurs orchestrent ces infrastructures via des frameworks tels que TensorFlow, PyTorch ou des plateformes managées. La parallélisation se décline en :
- parallélisme de données : chaque nœud traite un fragment différent du jeu d’entraînement ;
- parallélisme de modèle : les couches ou blocs du réseau se répartissent entre plusieurs nœuds ;
- techniques hybrides qui combinent les deux.
Applications concrètes des réseaux de neurones par secteur
Le deep learning n’est pas une technologie théorique confinée aux laboratoires de recherche. Il soutient des usages très concrets, parfois directement visibles dans la vie quotidienne, parfois plus discrets au cœur des systèmes d’entreprise.
Santé et médecine : diagnostic, pronostic et jumeaux numériques
Dans le domaine médical, les réseaux de neurones transforment l’analyse d’images et de signaux :
- imagerie médicale : IRM, radios, échographies, endoscopie ;
- détection de tumeurs cérébrales avec des architectures Mask R‑CNN ;
- analyse de mélanomes avec un niveau de précision comparable à celui d’un spécialiste ;
- diagnostics assistés pour les cancers du sein et de la peau, et travaux avancés sur les os et les poumons ;
- détection rapide de la malaria (jusqu’à 15 fois plus vite) ;
- modèles de prédiction de COVID‑19 avec des précisions mesurées autour de 92,4 % sur certains jeux de données.
Les réseaux de neurones s’emploient aussi pour :
- la prédiction d’insuffisance cardiaque, grâce à l’analyse automatisée de dossiers cliniques et de données hospitalières ;
- le suivi des signes vitaux en chirurgie, en évaluant en temps réel la perte de sang ;
- la création de digital twins (jumeaux numériques) de patients afin de simuler différents scénarios thérapeutiques et fournir des recommandations en temps réel.
À moyen terme, la médecine de précision alimentée par l’IA s’ouvre un marché estimé à plusieurs dizaines de milliards de dollars à horizon 2034, soutenu par l’exploitation conjointe de signaux médicaux, d’imagerie et d’historiques patients.
« Les modèles d’IA médicale n’ont pas vocation à remplacer les praticiens, mais à agir comme un second regard permanent, capable de parcourir rapidement des volumes de données considérables et de signaler les cas qui nécessitent une attention approfondie. »
Finance : scoring, fraude et trading algorithmique
En finance, les réseaux de neurones se positionnent comme des outils analytiques pour :
- le risque de crédit : réduction des défauts et accélération des délais d’approbation des dossiers ;
- la détection de fraude : identification de transactions inhabituelles, de schémas suspects ou d’usages anormaux de cartes ;
- le trading automatique : exploitation conjointe de réseaux de neurones récurrents, de modèles de séries temporelles (ARIMA) et de LSTM ;
- la prédiction de prix : analyse des tendances de marché, détection de signaux faibles dans de multiples flux d’information.
Les institutions combinent souvent deep learning et règles métier classiques. Les modèles de scoring résument des informations complexes, tandis que les contraintes réglementaires et les politiques internes encadrent les décisions finales.
Industrie, énergie et physique : simulation et optimisation
Les réseaux de neurones interviennent désormais dans des domaines traditionnellement réservés à la modélisation physique et aux systèmes dynamiques. On parle parfois de « physique informée » (physics‑informed AI), où les lois de la physique guident l’apprentissage.
Quelques exemples notables :
- modélisation de batteries et de matériaux, avec des simulations jusqu’à mille fois plus rapides que les approches classiques ;
- optimisation de réseaux électriques, pour réduire les perturbations d’environ 40 % et diminuer les coûts opérationnels d’environ 12,2 % ;
- pilotage prédictif d’équipements industriels, dans la perspective de maintenance conditionnelle et de réduction d’arrêt de production.
De nombreuses entreprises se tournent vers ces modèles hybrides, qui respectent les contraintes physiques tout en tirant parti de la puissance d’approximation des réseaux de neurones.
Cybersécurité : détection d’anomalies et comportement utilisateur
Les réseaux de neurones participent à la détection de malwares, à l’analyse de trafic réseau et à l’identification de comportements suspects. Les données peuvent être très variées : logs système, flux réseau, événements d’authentification, processus sur les postes clients.
Les modèles apprennent à reconnaître un profil d’activité normal pour chaque compte ou machine, puis signalent les écarts qui évoquent une compromission : escalade de privilèges, exfiltration de données, phases de reconnaissance internes.
La gestion de vulnérabilités s’appuie également sur ces techniques, afin de prioriser les correctifs en fonction du contexte réel et des schémas d’attaque observés sur le terrain.
Commerce, e‑commerce et marketing : personnalisation et prévisions
Dans le commerce de détail et l’e‑commerce, les réseaux de neurones alimentent :
- la prédiction de la demande à court et long terme ;
- les systèmes de recommandation qui ajustent les produits proposés à chaque profil ;
- l’hyper‑personnalisation de l’expérience mobile ;
- le suivi du churn et de la rétention client.
Dans certains scénarios d’hyper‑personnalisation sur mobile, les indicateurs s’améliorent nettement :
- taux de clic (CTR) multiplié par six ;
- taux de conversion (CVR) multiplié par trois ;
- CTR additionnel doublé ;
- rétention en hausse d’environ 30 % ;
- churn réduit d’environ 20 %.
Ces résultats reposent sur des architectures combinant embedding de produits, historique de navigation, signaux temps réel et modèles séquentiels ou Transformers.
Marché du deep learning et adoption par les entreprises
Le deep learning soutient plusieurs segments de marché en croissance, en particulier l’IA générative et le machine learning d’entreprise.
Poids économique de l’IA générative et du machine learning
Les estimations récentes indiquent :
- un marché de l’IA générative autour de 103,58 milliards de dollars en 2025 ;
- une projection vers 161 milliards de dollars en 2026 ;
- un marché du machine learning proche de 55,8 milliards de dollars en 2024, avec une perspective évaluée à environ 282,13 milliards de dollars à l’horizon 2030.
Les réseaux de neurones constituent la base technique de ces marchés, qu’il s’agisse de génération de contenu, de recherche sémantique, de classification automatique ou de systèmes de recommandation avancés.
Niveau d’adoption et transformation organisationnelle
Dans les entreprises, l’adoption suit plusieurs axes :
- le NLP est utilisé par environ 33 % des organisations pour l’analyse de texte, les chatbots, la classification de documents ;
- l’IA multimodale enregistre une progression constante, alimentée par les besoins d’analyse conjointe de texte, image, audio et vidéo ;
- l’IA appliquée à la physique (simulation, jumeaux numériques) est déjà présente dans près de 58 % des entreprises, avec une projection vers 80 % dans les deux prochaines années ;
- l’accès des collaborateurs à des outils IA devrait augmenter d’environ 50 % d’ici 2025.
Cette adoption élargit le rôle des équipes métiers dans les projets de deep learning : participation à la définition des cas d’usage, préparation des données, interprétation des modèles, validation des résultats en conditions réelles.
Tableau comparatif : deep learning, machine learning classique et approches symboliques
Pour mieux situer les réseaux de neurones dans l’ensemble des méthodes d’IA, le tableau suivant compare trois grandes familles : apprentissage profond, machine learning classique et IA symbolique.
| Critère | Deep learning (réseaux de neurones) | Machine learning classique | IA symbolique / règles |
|---|---|---|---|
| Type de données | Données massives, souvent non structurées (images, texte, audio, vidéo) | Données tabulaires, structurées, volumes modérés | Connaissances formalisées, règles métier, ontologies |
| Préparation des features | Apprentissage automatique de représentations hiérarchiques | Feature engineering manuel ou semi‑automatique | Pas d’apprentissage statistique, règles explicitement définies |
| Interprétabilité | Limitée, nécessite des techniques d’explicabilité dédiées | Souvent meilleure (arbres, régressions), selon le modèle | Très élevée, chaque règle est explicite |
| Besoin en données | Volume élevé, annotations parfois coûteuses | Volume plus réduit, données de qualité prioritaire | Pas de données d’entraînement nécessaires |
| Coût matériel | Accélérateurs (GPU, Trainium, TPU), infrastructures distribuées | Serveurs classiques suffisants dans de nombreux cas | Ressources faibles, mais effort humain de modélisation élevé |
| Domaine d’excellence | Vision, langage, audio, séries complexes, IA générative | Scoring, prévisions simples, classification tabulaire | Contrôle métier, conformité, logiques réglementaires |
Bonnes pratiques pour démarrer avec les réseaux de neurones
Mettre en œuvre un projet de deep learning repose sur une démarche structurée, depuis le choix du cas d’usage jusqu’à la mise en production.
Choisir un cas d’usage ciblé et mesurable
Un projet efficace s’appuie sur :
- un objectif métier clair : gains de temps, réduction de coûts, amélioration de la précision, diminution de risques ;
- des indicateurs mesurables : taux d’erreur, délai moyen, taux de détection, marge, taux de conversion ;
- un volume de données suffisant et accessible, avec une gouvernance solide.
Les premiers cas d’usage ciblent souvent l’automatisation de tâches répétitives, l’assistance au diagnostic ou la priorisation de dossiers, plutôt que des remplacements radicaux de processus existants.
Qualité des données et gouvernance
Les réseaux de neurones apprennent directement à partir des données fournies. Une donnée biaisée, déséquilibrée ou mal annotée conduit à un modèle biaisé, voire inéquitable.
Quelques points structurants :
- processus d’annotation cohérent, avec des consignes documentées ;
- échantillonnage réfléchi pour limiter les déséquilibres entre classes ;
- contrôle des doublons, des données bruitées et des erreurs de saisie ;
- suivi des droits d’usage, de l’anonymisation et de la protection des données personnelles.
Interprétabilité et acceptabilité
Dans des domaines sensibles (santé, finance, justice, assurance), la transparence et l’explicabilité conditionnent l’acceptation des modèles. Des approches comme LIME, SHAP ou les cartes de saillance offrent une vision partielle des facteurs ayant influencé la décision.
L’association d’un modèle de deep learning avec un niveau de validation humaine approprié renforce la confiance : alertes filtrées par l’IA, décisions finales validées par des experts, journalisation des prédictions pour audit ultérieur.
« Un modèle de deep learning ne remplace pas la responsabilité humaine. Il fournit un signal puissant, mais l’organisation garde la maîtrise des choix, de la gouvernance et des recours en cas d’erreur. »
Perspectives : multimodalité, jumeaux numériques et IA générative
Les réseaux de neurones évoluent vers des modèles capables de traiter simultanément plusieurs types de données : texte, image, son, signaux, interactions. Cette multimodalité ouvre la voie à des applications intégrées, qui dépassent les silos actuels.
Dans l’industrie et la santé, les digital twins et la physique informée offrent des simulations très rapides, utiles pour la R&D, l’optimisation énergétique, la maintenance prédictive ou la personnalisation des traitements.
L’IA générative repose sur des réseaux de neurones denses ou des Transformers capables de produire texte, image, audio ou code. Ce segment de marché s’installe durablement dans les stratégies technologiques des entreprises, en complément de modèles plus spécialisés pour les tâches critiques.
