Le machine learning transforme déjà la manière dont les entreprises analysent leurs données, prennent des décisions et automatisent des tâches autrefois manuelles. Derrière ce terme, l’« apprentissage automatique » désigne des méthodes statistiques et algorithmiques qui permettent à une machine d’améliorer ses performances à partir d’exemples, sans réécriture constante du code.
Entre promesses d’optimisation, usages concrets dans le marketing, la santé ou la cybersécurité, et freins réels à la mise en production, le sujet reste souvent nébuleux. Les chiffres d’adoption, les notions clés et les différents types de modèles racontent pourtant une histoire beaucoup plus structurée qu’il n’y paraît.
| Élément clé | Résumé |
| Objectif 🎯 | Apprendre automatiquement à partir de données pour réaliser des prédictions fiables. |
| Fonctionnement ⚙️ | Le modèle détecte des schémas dans les données et améliore ses décisions au fil des exemples. |
| Types d’apprentissage 📚 | Supervisé, non supervisé et par renforcement, selon la présence d’étiquettes et le but recherché. |
| Applications 🚀 | Recommandations, reconnaissance d’images, prédiction de tendances, automatisation. |
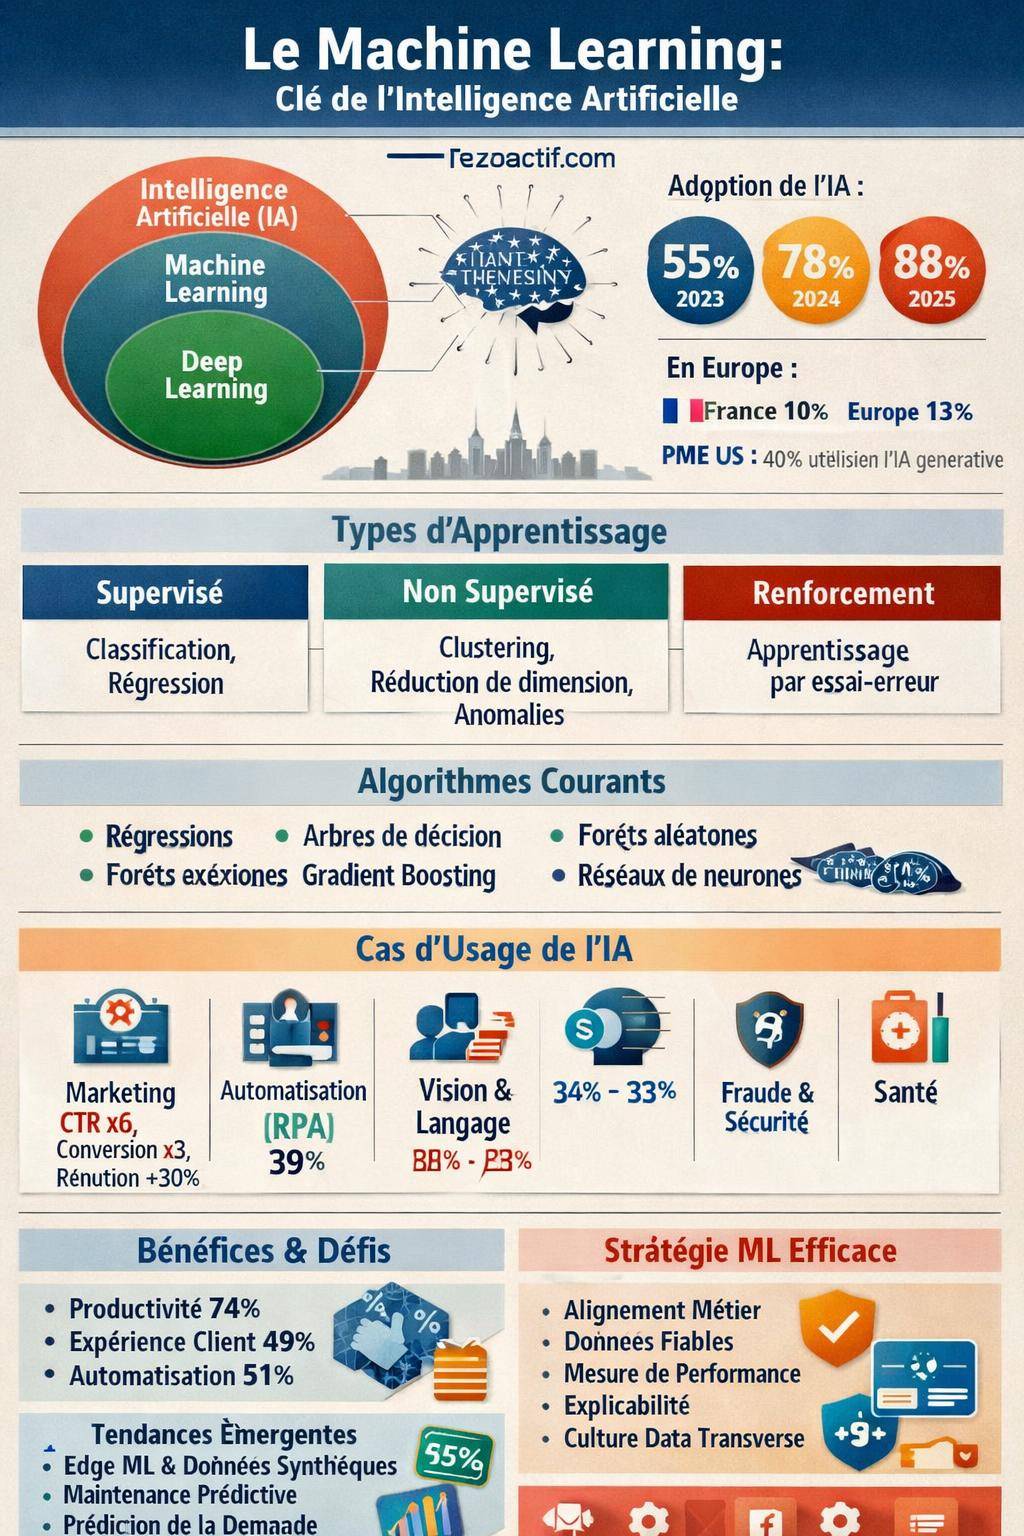
2025 : estimation — Sources : McKinsey, Gartner, Stanford AI Index
Machine learning : définition claire et place dans l’intelligence artificielle
Le machine learning, ou apprentissage automatique, désigne une branche de l’intelligence artificielle centrée sur la capacité d’un système à apprendre à partir de données. Au lieu de programmer chaque règle à la main, l’ingénieur fournit des exemples, et l’algorithme ajuste ses paramètres pour réduire ses erreurs.
Concrètement, un modèle de machine learning reçoit des données en entrée (images, texte, signaux, historiques de transactions, journaux systèmes) et produit une sortie : une prédiction, une classification, une recommandation, une estimation de probabilité. Le modèle s’entraîne sur un grand volume d’exemples, compare ses réponses avec la « vérité terrain », puis modifie ses paramètres internes en continu.
Le machine learning constitue aujourd’hui le cœur opérationnel de nombreux systèmes d’IA. Pour replacer ce domaine dans un cadre plus large, un lecteur curieux peut approfondir la définition simple de l’intelligence artificielle ou encore les différents types et catégories d’IA afin de bien situer l’apprentissage automatique dans l’écosystème global.
« Le machine learning n’est pas une boîte noire magique, mais un ensemble de méthodes capables d’extraire des régularités dans les données pour soutenir une décision, automatiser un traitement ou anticiper un comportement. »
Différence entre machine learning, IA et deep learning
Les termes se mélangent souvent, ce qui crée de la confusion. Un rapide cadrage simplifie la lecture :
- Intelligence artificielle : ensemble très large de techniques visant à reproduire des formes d’intelligence (raisonnement, perception, dialogue).
- Machine learning : sous-domaine de l’IA focalisé sur l’apprentissage à partir de données.
- Deep learning : famille de méthodes de machine learning utilisant des réseaux de neurones profonds, très adaptés aux images, au texte et à l’audio.
Les modèles de deep learning représentent aujourd’hui une grande partie des usages visibles (reconnaissance d’images, assistants vocaux, génération de texte), mais le machine learning plus « classique » (arbres de décision, forêts aléatoires, régression, SVM) reste très utilisé en entreprise, notamment pour la détection de fraude, la tarification ou le scoring de risque.
Adoption réelle du machine learning et de l’IA dans les entreprises
Les chiffres d’adoption montrent une progression nette des usages de l’IA et du machine learning, mais aussi un décalage marqué entre l’expérimentation et la création de valeur à grande échelle.
État des lieux mondial de l’adoption
Au niveau global, l’utilisation de l’IA dans les fonctions métiers progresse fortement. En 2023, 55 % des organisations déclaraient utiliser l’IA pour au moins une fonction métier. Cette part est montée à 78 % en 2024, puis 88 % en 2025. L’IA sort donc du cadre expérimental pour s’intégrer aux processus quotidiens.
La dynamique d’adoption globale suit la même trajectoire : en 2017, seules 20 % des entreprises utilisaient l’IA au moins dans un domaine. En 2025, environ 50 % des entreprises déclarent un usage effectif dans au moins un périmètre. Le machine learning sous-tend une grande partie de ces cas d’usage (détection de fraude, classification, prévision, recommandations).
Spécificités françaises et européennes
En France, la situation reste plus contrastée. En 2023, environ 6 % des entreprises françaises déclaraient utiliser l’IA. En 2024, ce taux grimpe à 10 %, ce qui indique une montée en puissance, mais laisse une marge de progression considérable. En Europe plus largement, environ 13 % des entreprises indiquent intégrer des usages d’IA en 2024.
Les PME et ETI françaises illustrent bien ce contraste. Environ 26 % utilisent déjà l’IA générative ou des solutions de machine learning, et 28 % ont des projets en cours de mise en place. Toutefois, 46 % des PME/ETI n’ont aucune intention déclarée d’adopter l’IA à court terme. Aux États-Unis, environ 40 % des PME utilisent déjà l’IA générative, ce qui souligne un différentiel d’adoption transatlantique.
| Pays / zone | Entreprises utilisant l’IA (2024) | Spécificités PME / ETI |
|---|---|---|
| France | 10 % | 26 % de PME/ETI utilisent l’IA générative, 28 % ont des projets, 46 % aucune intention |
| Europe (moyenne) | 13 % | Adoption variée selon les pays, forte hétérogénéité sectorielle |
| États-Unis | Non précisé (mais taux d’adoption plus élevé) | 40 % des PME utilisent l’IA générative |
Les grands types de machine learning expliqués simplement
Pour expliquer l’apprentissage automatique de manière claire, il suffit de distinguer trois grandes familles de méthodes, chacune adaptée à un type de problème métier.
Apprentissage supervisé : prédire et classer à partir d’exemples étiquetés
L’apprentissage supervisé utilise des données annotées. Chaque exemple d’entraînement est associé à une « bonne réponse » connue à l’avance. Le modèle apprend à reproduire ces réponses à partir des caractéristiques observées.
Deux grands types de tâches se distinguent :
- Classification : prédire une catégorie (spam / non spam, client à risque / client fiable, type de panne, segment marketing).
- Régression : prédire une valeur numérique (chiffre d’affaires attendu, montant de panier, durée d’un trajet, consommation d’énergie).
Dans un contexte business, l’apprentissage supervisé pilote de nombreux cas : scoring de risque, prévision de demandes, détection automatique de défauts sur une ligne de production, estimation de la probabilité de churn.
Apprentissage non supervisé : structurer et segmenter sans étiquettes
L’apprentissage non supervisé s’applique quand les données ne sont pas annotées. Le modèle cherche des structures internes : regroupements, corrélations, axes de variation dominants.
Les usages typiques incluent :
- Clustering (k-means, DBSCAN) pour créer des segments de clients, de produits, de documents.
- Réduction de dimension (PCA, t-SNE, UMAP) pour visualiser des données complexes ou préparer un autre modèle.
- Détection d’anomalies non supervisée, très utilisée en cybersécurité ou en maintenance industrielle.
Cette famille de méthodes structure les données pour préparer des actions marketing, éclairer des décisions de pricing, ou alimenter des modèles supervisés plus précis.
Apprentissage par renforcement : apprendre par essai-erreur
L’apprentissage par renforcement repose sur une logique d’agent qui interagit avec un environnement, reçoit des récompenses ou des pénalités, et ajuste sa politique d’action pour maximiser une récompense cumulée.
Cette approche se prête bien :
- à l’optimisation de stratégies de trading ou d’allocation d’actifs;
- au pilotage de robots industriels ou de véhicules autonomes;
- à l’optimisation de processus logistiques complexes;
- à l’ajustement dynamique de politiques de tarification ou de promotions.
Les tendances récentes mentionnent l’usage du reinforcement learning dans la robotique, la finance et la santé, avec des agents capables de s’adapter aux conditions de marché, d’environnement ou de patient qui évoluent en temps réel.
Algorithmes de machine learning : panorama des méthodes courantes
En pratique, l’apprentissage automatique s’appuie sur une panoplie d’algorithmes, chacun avec ses forces, ses limites et ses scénarios d’usage préférés.
Modèles linéaires et régressions
Les régressions linéaires et logistiques restent des bases fiables pour de nombreux problèmes. Elles affichent plusieurs atouts :
- interprétation simple des coefficients;
- entraînement rapide sur des volumes importants;
- facilité d’industrialisation et de contrôle réglementaire.
Ces modèles servent souvent de référence de départ pour un projet ML. Ils donnent une ligne de base chiffrée, contre laquelle comparer des modèles plus complexes.
Arbres de décision, forêts aléatoires et gradient boosting
Les arbres de décision modélisent les décisions sous forme de questions successives sur les variables (âge, pays, fréquence d’achat, historique de paiement, etc.). En assemblant plusieurs arbres, on obtient des forêts aléatoires ou des méthodes de gradient boosting (XGBoost, LightGBM, CatBoost).
Ces algorithmes offrent souvent un excellent compromis entre performance, robustesse et interprétabilité. Ils dominent de nombreux concours de data science tabulaire et équipent des cas d’usage centraux : scoring de crédit, prévision de ventes, priorisation de leads commerciaux, détection de défauts.
Réseaux de neurones et deep learning
Les réseaux de neurones artificiels organisent des couches de neurones interconnectés qui apprennent des représentations de plus en plus abstraites des données. Avec un nombre élevé de couches, on parle de deep learning.
Cette famille couvre :
- les CNN (convolutional neural networks) pour l’analyse d’images et de vidéos;
- les RNN et architectures dérivées pour les séries temporelles et certaines tâches séquentielles;
- les Transformers pour le traitement du langage naturel et la génération de texte;
- les architectures multimodales pour combiner texte, image, audio, signaux.
Le deep learning porte une part importante des usages de reconnaissance vocale, compréhension du langage naturel (NLU), vision par ordinateur, ainsi que les modèles d’IA générative utilisés pour la création de texte, d’images ou de code.
Cas d’usage concrets du machine learning aujourd’hui
Le machine learning irrigue de nombreux secteurs, souvent sans que l’utilisateur final en ait pleinement conscience. Les applications concrètes illustrent bien la variété des problématiques adressées.
Personnalisation, marketing et expérience client
Les recommandations personnalisées représentent un cas emblématique : moteurs de recommandation de produits, suggestions de contenus, offres adaptées au comportement de navigation. Ces systèmes apprennent à partir de l’historique de consultation, d’achat, de recherche, ainsi que des profils similaires.
L’hyper-personnalisation influence fortement les indicateurs marketing. Les tendances indiquent des gains quantifiés : taux de clic (CTR) multipliés par 6, taux de conversion (CVR) multipliés par 3, volume de notifications pertinentes doublé, avec une hausse de la rétention client de 30 % et une baisse de l’attrition de 20 %.
Les entreprises exploitent aussi le machine learning pour :
- segmenter les clients en groupes comportementaux précis;
- prédire le churn et déclencher des campagnes de rétention ciblées;
- ajuster les prix selon la demande prévue, la concurrence, la saisonnalité;
- analyser les sentiments exprimés dans les avis et les réseaux sociaux.
Productivité, automatisation et RPA
Du côté de la productivité interne, environ 74 % des organisations citent l’amélioration de la productivité comme principal bénéfice de l’IA. Le machine learning s’intègre souvent à des solutions de RPA (Robotic Process Automation) pour automatiser des séquences de tâches administratives.
Environ 39 % des cas d’adoption sectorielle se situent autour de la RPA : traitement de factures, rapprochement comptable, extraction automatique d’informations, classification de documents, priorisation des tickets de support. Dans ce cadre, le modèle apprend à reconnaître des motifs récurrents dans les documents ou les flux de travail.
Vision par ordinateur et reconnaissance
La vision par ordinateur mobilise le deep learning pour interpréter des images et des vidéos. Environ 34 % des cas d’adoption concernent ce domaine, avec des applications de :
- reconnaissance faciale et biométrique pour l’authentification ou la sécurité;
- détection de défauts en production industrielle;
- comptage automatisé d’objets, de personnes, de véhicules;
- analyse de rayons en retail pour suivre la disponibilité produits.
La recherche d’images par similarité illustre aussi cette tendance : un modèle apprend une représentation vectorielle des visuels afin de retrouver des images proches selon des critères sémantiques et non plus uniquement textuels.
Traitement du langage naturel et automatisation du service client
Approximativement 33 % des initiatives tournent autour de la compréhension du langage naturel (NLU). Les modèles de machine learning analysent les emails, les tickets, les conversations de chat, les appels transcrits pour :
- classer les demandes par thème et priorité;
- diriger automatiquement les requêtes vers la bonne équipe;
- proposer des réponses automatiques ou semi-automatiques aux agents;
- alimenter des bases de connaissances dynamiques.
Dans ce domaine, les entreprises utilisent aussi l’IA générative pour rédiger des réponses de service client, produire des résumés et générer du contenu d’aide contextuel. Environ 51 % des initiatives liées à la création de contenu, au service client ou à l’automatisation s’appuient déjà sur ces technologies.
Sécurité, fraude et cybersécurité prédictive
Les modèles de machine learning surveillent des flux massifs de données transactionnelles ou réseau pour identifier des anomalies : comportements de paiement inhabituels, accès suspects, modèles de fraude émergents.
Les solutions de cybersécurité prédictive s’appuient sur l’apprentissage automatique pour :
- détecter des comportements déviants en temps quasi réel;
- classer les alertes par criticité;
- renforcer les règles de détection en continu;
- anticiper des attaques en fonction de signaux faibles.
La détection de fraude dans les paiements, l’assurance ou le e-commerce s’inscrit dans cette logique, avec des modèles capables d’ajuster leurs seuils et leurs signaux en fonction des nouvelles tactiques d’attaque.
Santé, wearables et diagnostic assisté
Dans la santé, l’apprentissage automatique accompagne le diagnostic médical avec des modèles de classification d’images (radiologie, dermatologie, ophtalmologie), d’analyse de dossiers patients et de prévision des risques.
Les tendances annoncent une montée en puissance des wearables santé (montres, bracelets, capteurs) couplés à des modèles ML embarqués. L’edge machine learning autorise un pré-traitement directement sur le terminal, ce qui réduit la latence, limite l’envoi de données sensibles vers le cloud et améliore la réactivité pour la détection précoce de signaux critiques.
Chiffres clés : usage, bénéfices et décalage avec la mise en production
Les usages de machine learning progressent, mais la réalité économique montre un fossé notable entre expérimentation et industrialisation.
Priorités des entreprises : productivité, client, transformation
Les principales motivations déclarées par les organisations qui investissent dans l’IA et le machine learning se répartissent ainsi :
- 74 % citent la productivité comme objectif central;
- 49 % se concentrent sur l’amélioration de l’expérience client;
- 31 % relient directement ces projets à leur transformation numérique globale;
- 51 % mettent en avant l’automatisation, la création de contenu ou l’optimisation du service client.
Ce positionnement montre que le machine learning est envisagé autant comme un levier d’efficience interne que comme un moyen d’améliorer la relation client et de moderniser l’offre.
Production vs expérimentation : un écart marqué
Malgré cette dynamique, la création de valeur effective reste plus limitée :
- environ 7 % des entreprises déclarent générer une valeur économique tangible grâce à leurs initiatives d’IA;
- seulement 5 % des projets GenAI atteignent réellement la production;
- pourtant, 90 % des modèles d’IA utilisés en 2024 sont des modèles industriels ou disponibles sur étagère, ce qui montre une maturité technique.
De nombreux dirigeants perçoivent déjà la donnée comme un levier central : 59 % des décideurs considèrent les données comme un levier essentiel pour leur stratégie. La difficulté réside moins dans l’accès à des modèles que dans l’orchestration des données, la gouvernance, l’intégration aux systèmes existants et la conduite du changement.
Préparer un projet de machine learning : données, compétences, infrastructure
Un projet ML ne se résume pas au choix d’un algorithme. Les données, les équipes et l’infrastructure jouent un rôle déterminant.
Qualité et gouvernance des données
Le machine learning apprend à partir de données. Si ces données sont incomplètes, biaisées, mal structurées ou mal labellisées, le modèle reproduit et amplifie ces défauts. Une démarche de gouvernance des données structurée simplifie largement la suite du projet.
Cette démarche inclut :
- la définition claire des sources (CRM, ERP, web analytics, logs applicatifs);
- la standardisation des formats et des identifiants;
- un processus de nettoyage, de dédoublonnage et d’enrichissement;
- la traçabilité des transformations pour expliquer les résultats du modèle.
Formation des équipes et montée en compétences
La montée en puissance du machine learning s’accompagne d’un effort marqué de formation. Environ 66 % des entreprises forment déjà leurs employés à l’IA et au ML, et 50 % investissent dans leurs départements de formation pour structurer ces programmes.
Les compétences concernées couvrent plusieurs profils :
- data scientists pour concevoir, entraîner et évaluer les modèles;
- data engineers pour bâtir les pipelines de données et l’infrastructure;
- ML engineers pour l’industrialisation, le déploiement et le monitoring;
- métiers pour cadrer les cas d’usage, interpréter les résultats, piloter l’adoption.
Infrastructure et intégration dans le système d’information
En parallèle, environ 86 % des entreprises prévoient d’intégrer leurs solutions d’IA et de machine learning à leurs plateformes numériques dans les cinq prochaines années. Cette intégration suppose :
- des environnements d’entraînement (on-premise, cloud, hybride);
- des capacités de déploiement (API, microservices, batch, edge);
- un système de monitoring des performances, des dérives et des incidents;
- des mécanismes de sécurité et de conformité réglementaire.
« Un modèle de machine learning, sans pipeline de données robuste ni intégration propre au système d’information, reste un prototype. La valeur se crée au moment où le modèle répond à un besoin métier précis, avec des données fiables, dans un environnement surveillé. »
Machine learning et IA générative : complémentarités et limites
Les modèles d’IA générative occupent une place de plus en plus visible, mais s’appuient eux aussi sur des principes de machine learning. Ils apprennent des distributions sur les données (texte, image, audio) et génèrent de nouveaux contenus cohérents avec ces distributions.
Les entreprises combinent ces modèles génératifs avec des approches ML plus classiques :
- génération de brouillons de réponses, puis classification ou priorisation par des modèles supervisés;
- extraction de caractéristiques via des modèles de langage, puis scoring par un modèle tabulaire;
- résumé automatique de documents, suivi d’une détection d’entités et d’une catégorisation.
Les tendances indiquent une intégration croissante de l’IA générative dans les workflows métiers, avec des agents autonomes capables d’enchaîner plusieurs tâches (recherche, synthèse, création, exécution de scripts) sur la base de modèles de machine learning coordonnés.
Tendances à court terme : edge ML, données synthétiques, prévision avancée
Le paysage du machine learning évolue rapidement, avec plusieurs tendances marquantes pour les prochaines années.
Edge machine learning et capteurs intelligents
L’edge ML consiste à exécuter des modèles directement sur les appareils de bordure : capteurs, caméras, smartphones, objets connectés, robots. Cette approche réduit la dépendance au cloud, améliore la latence et renforce la confidentialité, car une partie des données reste localisée.
Les usages pressentis concernent :
- les wearables santé pour le suivi en continu de signaux physiologiques;
- la détection d’anomalies sur des machines industrielles, directement sur site;
- la supervision de la qualité de l’air, du bruit, de la température dans les bâtiments;
- la vidéo-intelligence embarquée dans les véhicules, les drones, les robots.
Données synthétiques et anonymisation avancée
La génération de données synthétiques par des modèles de machine learning ou d’IA générative facilite la création de jeux de données réalistes, sans exposer d’informations personnelles ou confidentielles.
Ces données servent à :
- renforcer l’entraînement sur des cas rares (fraude, pannes critiques, maladies peu fréquentes);
- tester des scénarios extrêmes pour la résilience des systèmes;
- partager des données entre partenaires en limitant les risques de fuite.
Prédiction de la demande, retail et logistique
La prédiction de la demande dans le retail gagne en précision grâce à des modèles ML qui intègrent saisonnalité, campagnes marketing, historique de vente, météo, événements locaux, signaux web. Les décideurs ajustent mieux les stocks, les promotions, les niveaux de réassort.
Les applications s’étendent à la logistique :
- optimisation des tournées de livraison;
- anticipation des congestionnements;
- gestion dynamique des capacités d’entrepôt;
- calibration des ressources humaines selon les pics d’activité.
Détection d’anomalies avancée et maintenance prédictive
Les modèles de détection d’anomalies avancée combinent des méthodes non supervisées, semi-supervisées et parfois des approches génératives pour identifier des comportements atypiques, même sans étiquettes préalables.
La maintenance prédictive dans l’industrie profite de cette approche : analyse de signaux capteurs, vibrations, températures, consommation d’énergie, pour repérer des dérives annonciatrices de panne. Les systèmes s’adaptent à la variabilité des conditions réelles, au lieu d’appliquer uniquement des règles statiques.
Structurer sa stratégie machine learning : quelques repères pratiques
Mettre en place une stratégie machine learning solide demande une approche structurée, articulée autour d’objectifs métiers et d’un socle de données fiable.
Aligner les cas d’usage sur les enjeux métiers
Une démarche efficace de machine learning part de questions métiers claires :
- réduire le churn sur une base d’abonnés;
- accélérer le traitement de tickets de support;
- améliorer la précision de prévisions de ventes;
- limiter les pertes liées à la fraude ou aux défauts qualité.
La priorisation des cas d’usage repose sur la valeur potentielle, la disponibilité des données, la faisabilité technique, ainsi que l’acceptation par les équipes concernées. Un cas plus modeste, mais bien aligné, crée souvent plus de valeur qu’un projet ambitieux mais déconnecté de la réalité opérationnelle.
Mesurer, piloter et expliquer les modèles
Un projet ML réussi repose sur des indicateurs clairs : précision, rappel, F1-score, AUC, mais aussi impact métier (réduction des coûts, augmentation du chiffre d’affaires, amélioration des délais, satisfaction client).
L’explicabilité occupe une place croissante. Les techniques d’interprétation (SHAP, LIME, importance des variables, visualisation de distributions) aident à :
- justifier une décision face à un client ou un régulateur;
- identifier des biais potentiels;
- détecter des dérives de comportement du modèle dans le temps.
Culture data et collaboration transverse
Enfin, une stratégie machine learning durable repose sur une culture data partagée. Les équipes métiers, techniques, conformité, sécurité et direction générale doivent travailler ensemble pour :
- formuler les besoins en termes de problèmes modélisables;
- mettre en forme les données nécessaires;
- ajuster les processus métier aux sorties du modèle;
- anticiper les impacts organisationnels et éthiques.
Cette collaboration transforme l’apprentissage automatique en un levier concret au service de la stratégie d’entreprise, plutôt qu’en une expérimentation isolée dans un laboratoire technique.
