
Un site rapide, bien structuré et proprement maillé obtient un crawl plus profond, plus fréquent et plus rentable pour le SEO. En coulisse, Google ajuste en continu le temps qu’il consacre à vos pages, en fonction de vos choix techniques et structurels.
En travaillant le SEO technique sous l’angle du crawl, on passe d’un simple site « indexé » à une architecture qui dirige les robots vers les bons contenus, au bon rythme. Les optimisations suivantes transforment un budget de crawl dispersé en un levier de croissance ciblé.
| Aspect clé | Enjeu principal | Impact sur le crawl 🚀 |
| Architecture du site | Hiérarchie claire et logique | Réduit la profondeur, facilite l’accès aux pages importantes |
| Maillage interne | Liens pertinents entre pages | Oriente efficacement les robots vers les zones prioritaires |
| Sitemap XML | Liste des URL essentielles | Accélère l’indexation des contenus stratégiques |
| Robots.txt | Filtrage des zones inutiles | Optimise le budget de crawl en évitant les pages sans valeur |
| Performance technique | Temps de chargement et stabilité | Encourage un passage plus fréquent des robots |
Donnees compilees a partir d audits SEO techniques (2023-2025) — panels de 50+ sites
SEO technique et crawl : comprendre le fonctionnement réel des robots
Le crawl correspond à l’exploration de vos pages par les robots des moteurs de recherche. Chaque visite du robot consomme une portion de votre crawl budget, c’est-à-dire le volume de pages que Google accepte d’explorer sur une période donnée. Ce budget n’est pas infini, surtout pour les sites volumineux ou lents.
Pour structurer un site efficace, il faut se concentrer sur deux piliers : la crawl capacity (ce que votre serveur supporte réellement) et la crawl demand (l’intérêt que Google porte à vos contenus). Toute la stratégie technique vise à orienter ce budget vers les pages à forte valeur : catégories stratégiques, pages produits importantes, contenus éditoriaux structurants.
Crawl budget : un levier mesurable, pas un concept théorique
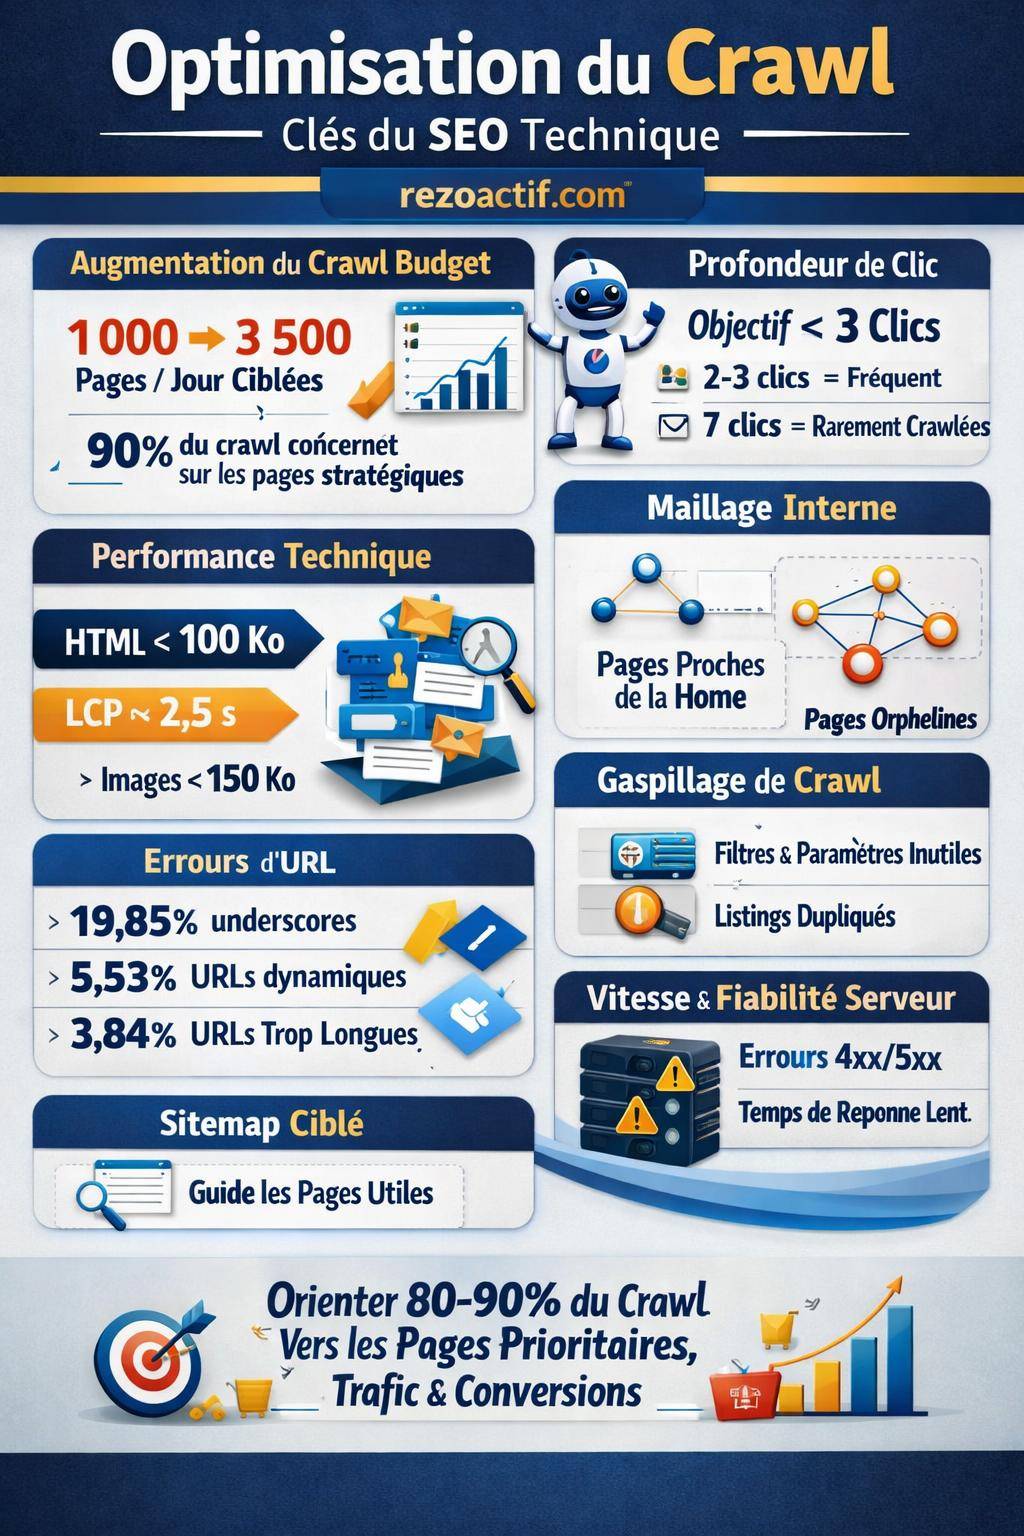
Sur un site e-commerce ou média, le crawl se mesure concrètement. Un cas typique : une home crawlée une dizaine de fois par jour, des catégories profondes à 7 clics visitées seulement une fois par mois. Après optimisation de structure, le budget peut passer d’environ 1 000 à 3 500 pages/jour, avec jusqu’à 90 % du crawl concentré sur les produits et catégories stratégiques. Les nouveaux produits sont alors explorés en moins de 48 heures, au lieu de rester invisibles plusieurs semaines.
Ce type de progression repose surtout sur des ajustements structurels : profondeur de clic, poids des pages, maillage interne, gestion des filtres et des paramètres, nettoyage des URLs inutiles. Tout ce qui suit vise justement à obtenir ce genre de redistribution du crawl.
« Un bon crawl n’est pas celui qui parcourt tout le site, mais celui qui parcourt les bonnes pages, au bon moment. »
Profondeur de clic : architecturer le site pour un crawl efficace
La profondeur de clic désigne le nombre de clics nécessaires depuis la page d’accueil pour atteindre une URL. Les analyses de logs montrent une corrélation nette : entre 2 et 3 clics, le crawl reste fréquent ; à 7 clics, les robots ne repassent parfois qu’une fois par mois.
Pour un site orienté performance SEO, une profondeur ≤ 3 clics pour les pages stratégiques constitue une référence. Au-delà, les contenus deviennent difficiles à explorer, surtout si le maillage est pauvre ou si le serveur réagit lentement.
Cartographier la profondeur de clic de votre site
Une approche structurée commence par une cartographie : quelles pages se trouvent à 1 clic (home, hubs majeurs), 2 à 3 clics (catégories, contenus piliers), puis plus de 4 clics (produits lointains, archives, contenus peu reliés). Des outils de crawl SEO ou un export de structure permettent d’obtenir cette vision.
Sur cette base, on isole les pages stratégiques excentrées. L’objectif : les remonter structurellement, via le menu, les blocs de navigation interne, ou des hubs de contenus thématiques. Plus les pages à forte valeur se rapprochent de la home, plus elles reçoivent de popularité interne et de visites de robots.
Techniques concrètes pour réduire la profondeur
Plusieurs leviers structurels améliorent la profondeur sans transformer complètement l’arborescence :
- Créer des pages hubs par univers sémantique (catégories intermédiaires, pages de liste éditorialisées).
- Ajouter des liens contextuels depuis les contenus les plus puissants vers les pages profondes.
- Mettre en place des blocs « Produits / articles populaires » dans les templates clés.
- Repenser la navigation secondaire (liens dans le footer, colonnes latérales) pour rapprocher des zones cruciales.
Une profondeur maîtrisée ne se joue pas uniquement dans le menu principal. Le maillage interne contextuel occupe un rôle central, en complément de l’arborescence par rubriques.
Poids des pages et performance : des robots limités par vos choix techniques
Le poids HTML influe directement sur le nombre de pages que les robots peuvent explorer durant une session. Des pages légères, en dessous de 100 Ko de HTML, permettent aux robots de parcourir davantage d’URLs à chaque visite. À l’inverse, des pages supérieures à 2 Mo de HTML sont parfois tronquées : le robot ne lit pas tout le contenu et l’indexation reste partielle.
Cette réalité dépasse la seule vitesse perçue par l’utilisateur. Le code « gonflé » (scripts inutiles, composants répétés, inline CSS) consomme le budget de crawl sans bénéfice pour le référencement. Décharger les templates de tout ce qui n’est pas indispensable améliore immédiatement la capacité d’exploration.
Core Web Vitals et crawl : un même socle technique
Les Core Web Vitals structurent désormais les exigences techniques :
- LCP < 2,5 s : temps de chargement de l’élément principal.
- INP < 200 ms : réactivité globale aux interactions.
- CLS < 0,10 : stabilité de l’affichage.
- Images clés < 150 Ko : visuels principaux compressés et adaptés.
Un site qui respecte ces seuils se positionne mieux pour un crawl fluide : serveur plus disponible, temps de réponse stables, absence de surcharge sur les ressources critiques. Cette stabilité rassure Google sur la capacité du site à supporter une fréquence d’exploration plus élevée.
| Élément technique | Niveau optimisé | Impact sur le crawl |
|---|---|---|
| Poids HTML | < 100 Ko | Plus de pages explorées par session |
| Images principales | < 150 Ko, formats modernes (WebP, AVIF) | Moins de bande passante consommée, temps d’exploration réduit |
| LCP | < 2,5 s | Améliore la perception de performance côté Googlebot |
| INP | < 200 ms | Limite les blocages JS, garantit la disponibilité |
| CLS | < 0,10 | Affichage stable, expérience plus lisible pour l’utilisateur |
Maillage interne : orienter le robot vers les bonnes pages
Le maillage interne joue un rôle décisif dans la répartition de la popularité et dans la fréquence de crawl. Les pages proches de la home, fortement reliées, bénéficient d’un link equity plus élevé et d’un passage robot plus régulier. À l’inverse, les pages orphelines, sans liens entrants internes, restent difficiles à découvrir et à indexer.
Une stratégie de liens internes cohérente agit comme un plan de circulation pour Googlebot : elle indique les priorités, révèle les clusters sémantiques et renforce les pages mères face aux contenus satellites.
Structurer un maillage interne orienté business
Un maillage interne optimisé ne se limite pas au menu principal. Il combine plusieurs niveaux de liens :
- Liens de navigation (menu, fil d’Ariane, footer) pour la structure globale.
- Liens contextuels dans les textes, vers les pages piliers ou les pages transactionnelles.
- Blocs automatiques de type « articles liés », « produits similaires », soigneusement configurés pour éviter la dilution.
Cette organisation oriente la popularité vers les pages à forte valeur et évite qu’elle se disperse sur des templates techniques, des pages de filtres ou des contenus très proches sémantiquement (risques de cannibalisation).
Repérer les pages orphelines et les intégrer intelligemment
Les pages orphelines représentent une source de gaspillage du budget de crawl. Elles peuvent être techniquement accessibles via le sitemap ou un lien externe, mais totalement isolées à l’intérieur du site. Les logs révèlent souvent peu de visites de robots, voire aucune.
La solution passe par une double approche : audit pour les identifier (comparaison des URLs crawlées, indexées, et présentes dans la base interne), puis intégration dans un cluster thématique. Un lien contextuel depuis une page forte ou l’ajout à une liste catégorielle suffit souvent à relancer le crawl et l’indexation.
Pour approfondir l’approche globale du référencement et du rôle du maillage, un contenu de fond sur le SEO en marketing donne un cadre utile avant d’entrer dans les aspects purement techniques.
Sitemaps XML et indexation : un signal, pas une garantie
Un sitemap XML bien construit aide les moteurs à identifier l’ensemble des URLs importantes. Lorsqu’un site soumet par exemple 500 URLs dans un sitemap et que 500 sont indexées, la couverture semble correcte. Pourtant, ce signal ne garantit pas une indexation durable, ni une fréquence de crawl adaptée.
Le sitemap fonctionne comme une liste d’intention : « voici les pages que le site juge stratégiques ». Le moteur confronte ensuite cette liste à la réalité : performance, duplication, maillage, profondeur, engagement utilisateur. Si ces signaux restent faibles, certaines pages indexées finissent désindexées ou crawlées très rarement.
Construire un sitemap cohérent avec la stratégie de crawl
Un sitemap efficace reflète une sélection :
- Exclure les pages de tests, de staging, ou temporaires.
- Éviter les paramètres d’URL, filtres et facettes destinés surtout à la navigation.
- Limiter aux pages stables, utiles, avec un contenu réellement unique.
La mise à jour régulière du sitemap, en particulier pour les sites e-commerce à fort renouvellement de produits, aide les robots à prioriser les nouvelles références ou les catégories récemment renforcées. Combiné à un bon maillage, le sitemap devient un accélérateur de crawl, sans jamais remplacer le travail sur l’architecture.
Facteurs techniques qui modèlent le crawl budget
Le crawl budget dépend de deux dimensions principales : la crawl capacity limit et la crawl demand. La première renvoie à ce que vos serveurs peuvent supporter ; la seconde traduit l’intérêt que Google porte réellement à vos contenus.
Lorsque les serveurs répondent lentement ou renvoient des erreurs fréquentes, Google réduit spontanément la pression de crawl. À l’inverse, des performances stables et une structure claire incitent les robots à intensifier l’exploration, en particulier sur les zones en croissance ou fréquemment mises à jour.
Crawl capacity limit : performances serveur et erreurs
La crawl capacity limit regroupe plusieurs facteurs :
- Temps de réponse serveur : plus il augmente, plus Google ralentit le rythme des requêtes.
- Codes 5xx et 4xx : une accumulation d’erreurs signale un environnement instable.
- Ressources bloquantes (scripts lourds, temps de connexion) : elles allongent les sessions de crawl.
Un monitoring régulier via les logs serveur et la Search Console aide à repérer les périodes de tension. L’objectif reste d’offrir un environnement prévisible : pas de pics d’erreurs, réponses homogènes, infrastructure capable de supporter une montée en charge du crawl lors des mises à jour massives.
Crawl demand : popularité et fraîcheur du contenu
La crawl demand tient davantage de la dynamique éditoriale et de la popularité :
- Pages recevant des backlinks : Google revient plus souvent.
- Contenus régulièrement mis à jour : les signaux de fraîcheur stimulent la demande.
- Pages générant des impressions et des clics organiques : la Search Console laisse entrevoir ces tendances.
Un site qui publie de manière cohérente, enrichit ses contenus existants et organise ses thématiques via des pages piliers alimentées, soutient une crawl demand constante. L’architecture et le maillage interne servent alors de guide pour redistribuer ce flux vers les sous-pages stratégiques.
Grands sites : gaspillage de crawl et pièges structurels
Plus un site grandit, plus les risques de gaspillage de crawl budget augmentent. Sur un catalogue e-commerce ou un média à fort volume, les robots se perdent rapidement dans des pages à valeur réduite : filtres, facettes, listings similaires, archives très proches sémantiquement.
Les logs d’exploration révèlent souvent un temps considérable perdu sur des facettes inutiles, des URL de tri, ou des redirections en chaîne. Pendant ce temps, des produits stratégiques ou des contenus récents reçoivent peu ou pas de visites de robots.
Filtres, facettes et navigation à facettes
Les filtres et facettes constituent une source récurrente de duplication et de gaspillage :
- Combinaisons infinies de paramètres dans l’URL.
- Pages quasi identiques, avec seulement un ordre différent ou un filtre marginal.
- Crawl massif de pages sans réelle demande utilisateur.
La stratégie consiste à définir un socle de facettes indexables (par exemple, catégorie + marque + gamme), et à bloquer le reste par robots.txt, balises meta noindex, ou gestion des paramètres. Chaque choix doit être aligné avec les intentions de recherche réelles, tout en protégeant le budget de crawl.
Chaînes de redirections et URLs inutiles
Les chaînes de redirections (par exemple A → B → C) consomment un nombre de requêtes disproportionné. Les robots suivent ces chaînes mais gaspillent une partie de leur budget sur des chemins qui n’apportent aucune nouvelle information.
Le nettoyage passe par :
- La réduction des chaînes à une seule redirection 301.
- La suppression des redirections obsolètes ou circulaires.
- La mise à jour des liens internes pour pointer directement vers les nouvelles URLs.
Un environnement de redirections maîtrisé stabilise le crawl et renforce la cohérence des signaux envoyés à Google.
Erreurs d’URL et normalisation : assainir l’espace d’exploration
Les URLs incohérentes ou mal construites brouillent les signaux envoyés aux moteurs. Sur certains sites, près de 19,85 % des erreurs proviennent encore d’underscores dans les URLs, 5,53 % d’URLs dynamiques mal gérées, et 3,84 % d’URLs trop longues.
Ces problématiques s’ajoutent à la duplication : majuscules vs minuscules, trailing slash, variantes avec et sans paramètres. Chaque variante finit par consommer des ressources de crawl sans enrichir l’index.
Bonnes pratiques de construction d’URL
Une structure d’URL stable et prévisible repose sur quelques principes :
- Utiliser des tirets plutôt que des underscores pour séparer les mots.
- Limiter la longueur en se concentrant sur les termes réellement pertinents.
- Éviter d’exposer les IDs techniques ou paramètres internes lorsque ce n’est pas nécessaire.
- Imposer une seule version canonique pour chaque page (gestion du slash final, des www, du HTTP/HTTPS).
Ce cadre réduit considérablement les variantes inutiles et renforce la compréhension du site par les moteurs, ce qui rejaillit sur la qualité du crawl et sur la façon dont chaque page est évaluée.
Robots.txt, balises meta et canonicals : orienter le robot avec précision
Les fichiers robots.txt, les balises meta (index / noindex, follow / nofollow) et les balises canonical servent de signaux de pilotage pour le crawl et l’indexation. Une mauvaise configuration se traduit rapidement par un gaspillage de crawl ou par l’indexation de mauvaises versions.
Un robots.txt trop permissif laisse Googlebot explorer des zones inutiles. À l’inverse, un blocage sur des répertoires clés empêche la découverte de pages pourtant stratégiques. La granularité de ces signaux doit s’aligner sur la stratégie de contenu et sur la façon dont le site gère ses variantes.
Robots.txt : filtrer sans étouffer
Le robots.txt contrôle l’accès aux répertoires et certains patterns d’URL. Les erreurs fréquentes incluent :
- Blocage involontaire de répertoires /assets/ ou /js/ nécessaires au rendu.
- Blocage global de /search/ ou /filter/ sans stratégie alternative.
- Absence totale de directives sur les paramètres les plus problématiques.
Un robots.txt utile cible les zones à décroître en priorité (filtres sans enjeu SEO, paramètres de tri), tout en laissant l’accès complet aux gabarits de pages importantes : catégories, fiches produits clés, contenus éditoriaux structurants. Le but consiste à orienter le crawl, pas à masquer arbitrairement de grands segments.
Balises meta et canonicals : maîtriser les versions indexées
Les titres et meta descriptions mal optimisés nuisent à l’indexation indirectement : ils génèrent des taux de clic faibles, ce qui réduit l’intérêt des robots pour certaines pages. Des balises Canonical mal paramétrées transfèrent parfois la valeur vers des versions moins pertinentes, ou vers des URLs techniques.
Les principaux chantiers :
- Aligner chaque canonical sur l’URL réellement prioritaire du point de vue business et SEO.
- Éviter les canonicals en chaîne ou contradictoires.
- Utiliser des balises noindex pour les pages dont on veut conserver l’utilité pour l’utilisateur, sans les exposer à l’index (ex : certaines pages de filtrage).
Une architecture où chaque URL possède une version canonique claire limite les confusions et concentre le crawl sur les pages qui comptent réellement.
Navigation, technologies front et cohérence globale
La façon dont la navigation est implémentée influence directement le parcours des robots. Des systèmes reposant largement sur Flash, JavaScript complexe ou AJAX non progressif gênent encore l’exploration, surtout lorsque les liens sont générés côté client sans fallback HTML.
Une navigation basée principalement sur du HTML et du CSS, enrichie éventuellement par du JS non bloquant, supporte mieux le crawl. Les liens doivent rester visibles dans le DOM côté serveur pour que Googlebot les interprète correctement, même avec un rendu limité.
Éviter les blocages d’exploration liés au front
Les obstacles fréquents incluent :
- Menus entièrement gérés par JS, sans présence des liens dans le code HTML initial.
- Infinite scroll sans pagination alternative accessible par lien.
- Liens cliquables via onClick sans attribut
hrefclassique.
Pour chaque pattern de navigation, une variante crawlable doit exister : pagination HTML, liens dans le footer, sitemap HTML pour les zones profondes. L’objectif reste de permettre à Googlebot de suivre le même cheminement logique qu’un utilisateur, même sans exécuter le JavaScript.
Erreurs d’exploration et cohérence de la structure
Les liens brisés, erreurs 404 non maîtrisées et problèmes techniques récurrents interrompent l’exploration. Trop de renvois vers des pages inexistantes diminuent la confiance du moteur dans la qualité globale de la structure, et entraînent un ralentissement du crawl.
Une démarche efficace consiste à surveiller en continu :
- Les rapports « Erreurs d’exploration » de la Search Console.
- Les codes 404 et 5xx issus des logs serveur.
- Les chemins d’exploration incomplets (crawl interrompu dans certaines branches).
La cohérence du site – arborescence claire, peu de contenus redondants, gabarits stables – offre un terrain propice à une exploration régulière. Cette cohérence vaut davantage qu’une multiplication opportuniste de pages à faible valeur.
Content pruning : épurer le contenu pour redonner du souffle au crawl
Le content pruning consiste à rationaliser le contenu existant. Plutôt que d’empiler les articles ou fiches produits très proches, on identifie les pages qui n’apportent plus de valeur et on restructure l’ensemble. Ce processus se déroule en plusieurs étapes structurées.
Une approche en 6 étapes se révèle efficace : inventaire, qualification des pages, décision (conserver, fusionner, rediriger, supprimer), réécriture, maillage, suivi. L’objectif vise à éliminer les doublons, réduire la cannibalisation, et orienter les robots vers un corpus plus resserré et plus solide.
Choisir les pages à conserver ou à supprimer
Les décisions s’appuient sur un ensemble de métriques :
- Trafic organique actuel et historique.
- Impressions et clics dans la Search Console.
- Taux de rebond et temps passé.
- Conversions et objectifs business atteints.
- Backlinks obtenus.
- Liens internes reçus et rôle dans le maillage.
- Partages sociaux et signaux d’engagement.
Une page avec peu de trafic mais une forte valeur de conversion ou des liens externes qualitatifs mérite souvent d’être consolidée plutôt que supprimée. À l’inverse, des séries d’articles quasi identiques sans signaux positifs peuvent être fusionnées en un contenu plus complet et mieux positionné.
Redirections 301, risques et cannibalisation
La redirection 301 transfère la majorité de la valeur SEO d’une page vers une autre. Lorsqu’elle est bien utilisée, elle renforce les contenus restants et réduit la dispersion des signaux. Utilisée massivement et sans discernement, elle provoque des chutes de trafic et un brouillage du maillage.
Une vigilance particulière s’impose face à la cannibalisation : plusieurs pages traitant le même sujet se disputent les mêmes requêtes. Fusionner ces contenus en une page pilier unique, bien structurée, soutenue par des liens internes, améliore l’efficacité du crawl et clarifie l’offre éditoriale.
Priorités techniques SEO à l’horizon 2026 : un crawl orienté valeur
Les tendances récentes convergent vers quelques priorités techniques stables : des pages rapides et accessibles, un balisage clair, et une gestion fine des erreurs 404 et redirections. Ces éléments déterminent en grande partie la façon dont Google investit son temps de crawl sur votre domaine.
Un site qui maintient un niveau technique propre soutient ensuite ses efforts éditoriaux, de netlinking et d’optimisation on-page. Pour des méthodes d’optimisation sémantique plus détaillées, un guide dédié sur comment faire du SEO complète utilement ce socle technique orienté crawl.
« Le SEO technique n’est pas un chantier ponctuel, mais une discipline d’entretien : chaque évolution du site influe sur la façon dont les robots lisent, comprennent et priorisent vos contenus. »
Une architecture claire, des URLs propres, un maillage réfléchi et un contenu élagué forment ainsi un environnement où le crawl devient un allié du business, et non un simple indicateur technique dans un outil d’audit.
